这几天学习了一下 Anthropic 在今年 7 月份发布的关于可视化模型的全局工作空间相关的工作, 感觉非常有启发. 因此想要对文章记录我的理解和想法.
摘要
这篇笔记通过剧院类比介绍全局工作空间是什么, 从而引出 Anthropic 这篇文章的核心思想: 如何观察大模型的"全局工作空间". 我们会先看看他们用来观察和干预模型中间表征的工具(J-Lens 与 J-Space)是怎么工作的. 再看研究者是如何用这些工具和实验设计来说明大模型可能存在全局工作空间和它所包含的一些有趣性质. 最后, 我也会讨论一些我对于这篇文章的一些看法和思考.
全局工作空间理论
1988年, 本就乌云密布的认知科学里存在着这样一朵乌云, 为什么我们可以有意识的汇报一部分的大脑活动, 而对另一部分却无法自知, 看不见的大猩猩实验 (Simons, 1999) 非常可以体现这个现象, 如果不知道这个实验的朋友可以看一下这个视频:
很明显, 猩猩实验中, 眼睛的输入信号必然是包含了大猩猩的像素, 并被视觉皮层处理, 而这部分的像素并没有被意识捕捉到. 这个实验非常简洁的告诉了我们, 并不是所有信号都能够进入意识. 那么, 大脑的信息处理到底是一个什么样的机制? 这就是那时认知科学中的一朵乌云.
Bernard Baars 为了解决这个问题, 提出一个可能的理论, 那就是全局工作空间 (GWT, Baars, 1988).
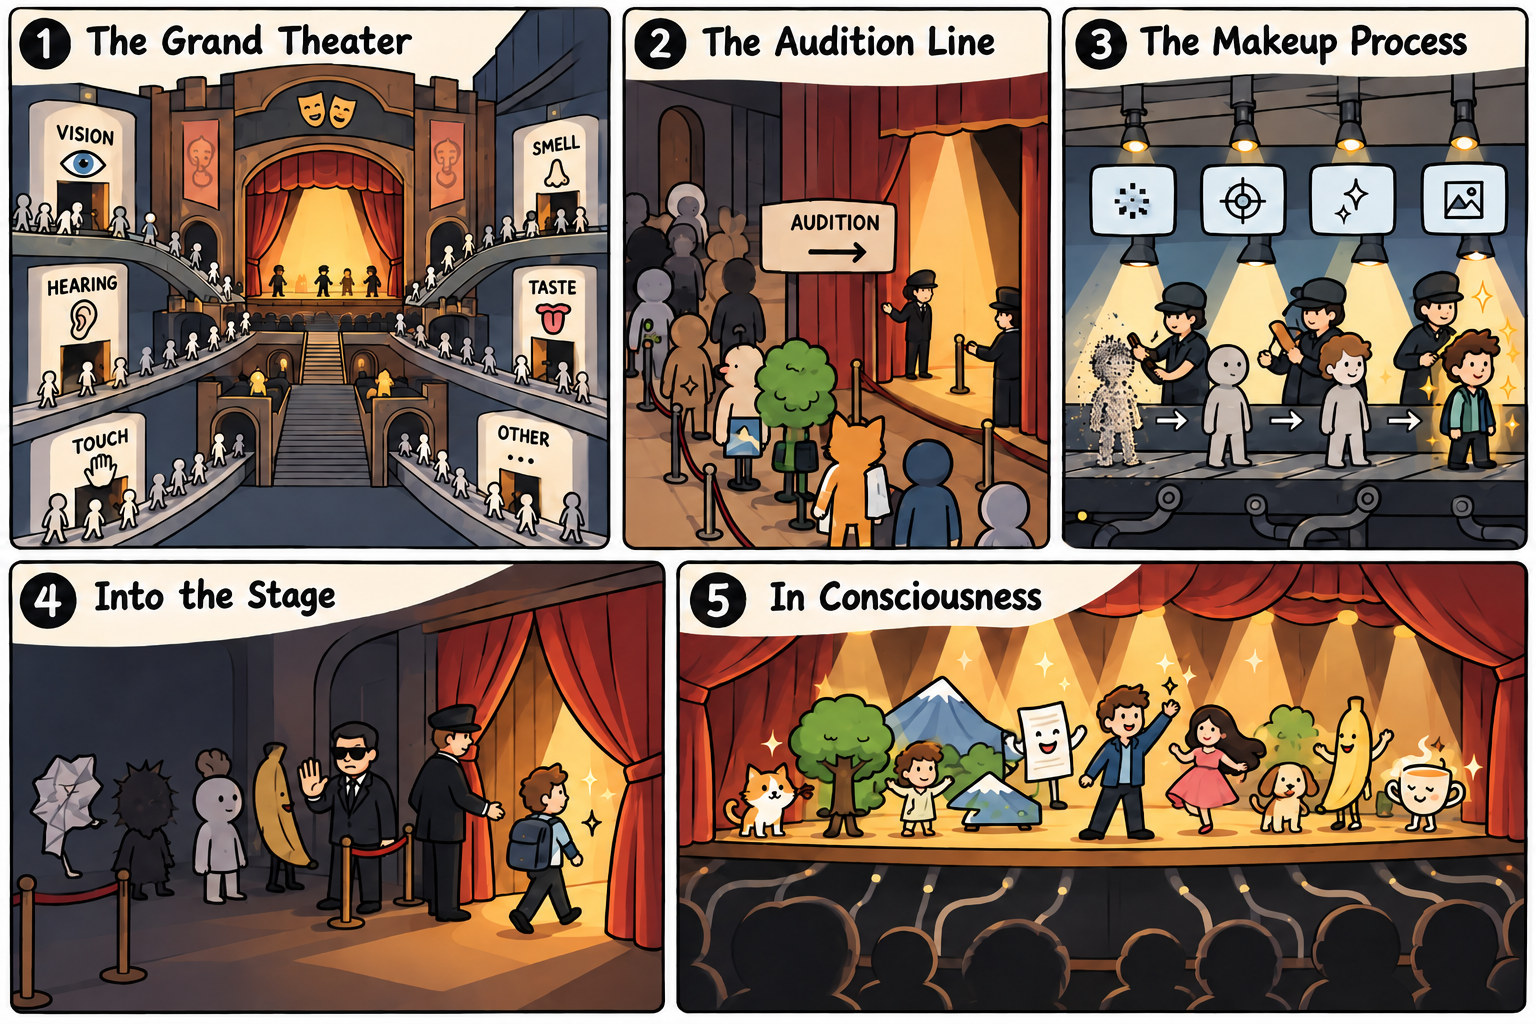
这个理论非常的形象化. 它说, 人的整个认知系统就像是一个大剧院, 剧院的中央舞台就是全局工作空间, 这个舞台里的道具和演员就是我们的意识可以感知到的这些对象. 当然, 这个剧场非常特殊(毕竟是认知系统!), 围在舞台周围的观众, 对应的是各种专门处理信息的脑回路.
我们的大脑时刻要处理来自身体这边传来的各种信息, 可能有闻到香气嗅觉信息, 可能有感受键盘敲击的触觉信息, 可能有观察到叶片纹理的视觉信息, 可能有被路边骂街惊动的听觉信息, 也可能有尝到淡雅茶香的味觉信息, 这些信息会被大脑中的各种小回路或者小的函数处理尝试彼此竞争进入舞台.
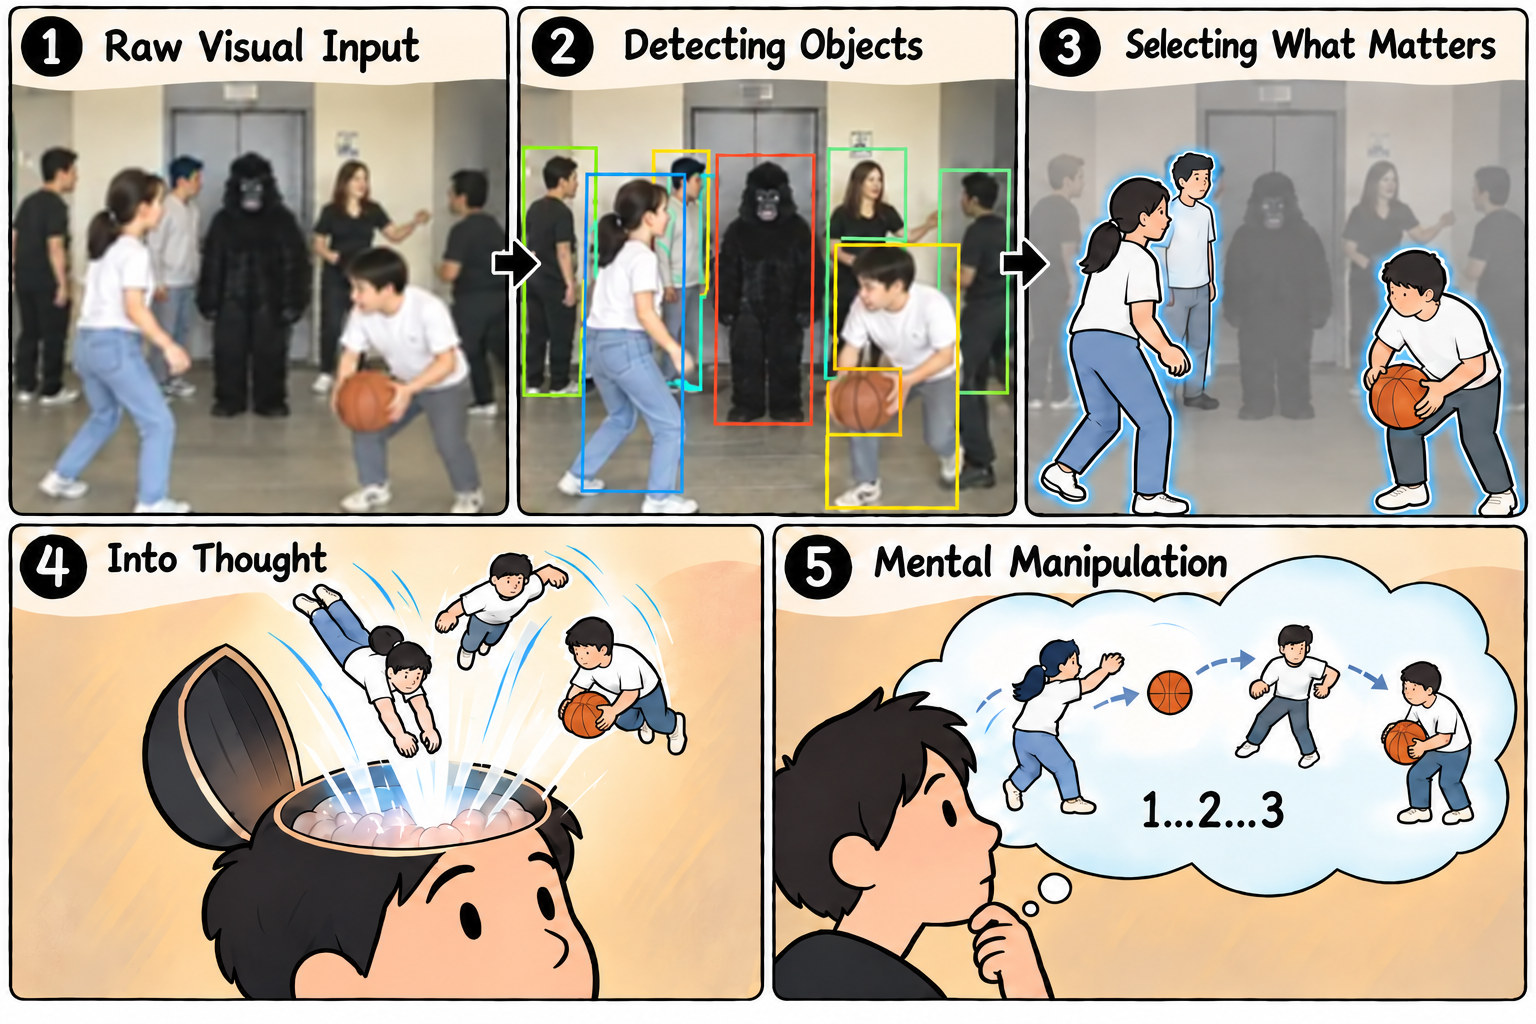
这些回路就好像各自是精致的化妆师, 他们尝试让沿着中央大道一路跑进剧院的试演者进行化妆, 回到 "看不见的大猩猩" 实验举例, 有些人可能连大门都进不了(比如屏幕外的部分), 有些人长得就一副很适合做演员的样子(白色衣服的球员), 有很多路演(黑色衣服的球员), 还有些虽然进了剧院却被舞台拒之门外(大猩猩).
化妆师们 (大脑中的小处理器) 就开始给这些演员一个一个化妆, 试演们一层一层的向着化妆流水线往前走, 到舞台前时已经从刚进来的素装成为了西装笔挺浓妆艳抹的帅小伙, 舞台筛选员看着他面色不错就让他上了舞台, 有些太不起眼可能就就会被筛选员拒绝上台.
对应状态可能就是眼睛的视觉信息从最初的满是噪点的输入, 经过处理将内容清晰化, 将看到的事物中抓人眼球的部分先被送上舞台, 进入意识. 一旦上了舞台, 这些演员们就成为了可以被意识观察, 被操控(推理, 平移旋转) 的对象.
而这个舞台之所以叫做“全局”工作空间, 关键还在于广播: 一旦某个信息进入舞台, 它就可以被周围多个专门处理系统共同读取和使用. 这些系统不仅处理外界的感官输入, 也包括记忆、推理、决策和语言等功能.
比如看到山上的乌云后, 同一条信息可以让记忆系统联想到之前淋雨的经历, 让决策系统考虑是否下山, 也让语言系统组织出“可能要下雨了”这句话. 因此, 上台不仅意味着进入意识, 还意味着这条信息可以被多个系统灵活地使用.
这就是全局工作空间, 他给我们意识中可观察和操控的这些概念提供了一个舞台.
大模型也存在全局工作空间 (J-Lens and J-Space)
J space 这篇文章的核心主旨就是, 大模型可能存在类似于 "全局工作空间"(GW) 的东西. 对于大模型来讲, 他的全局工作空间怎么确定他存在呢? 他肯定存在于 Transformer Block 的层层递进当中, 可是我们怎么就能说明他这些不可理解的中间层就是GW呢?
于是文章提出了两个概念, 一个叫做 J-Lens, 另外一个叫做 J-Space.
J-lens 是用来查看当前时刻大模型的GW是属于什么样的状态的, 而 J space 则是对其中可以被这套方法读出的表征所构成的状态空间的一种数学化定义. 可以把它理解为GW的一个近似的可读状态空间, 我会接下来逐一介绍.
J-lens 是看清舞台上的演员的放大镜
既然我们关心某一层是否具备某种工作空间的性质, 那么我们想要可以发现这些演员. 我们观察的方式就是 J lens.
J lens 的定义如下:
其中 是 Transformer block 中 层, sequence 位置 的 hidden state
这个公式看上去很唬人, 但是他的意义其实非常简单: 那就是平均意义下, 第 层的 transformer block 会对未来产生一个什么样的影响.
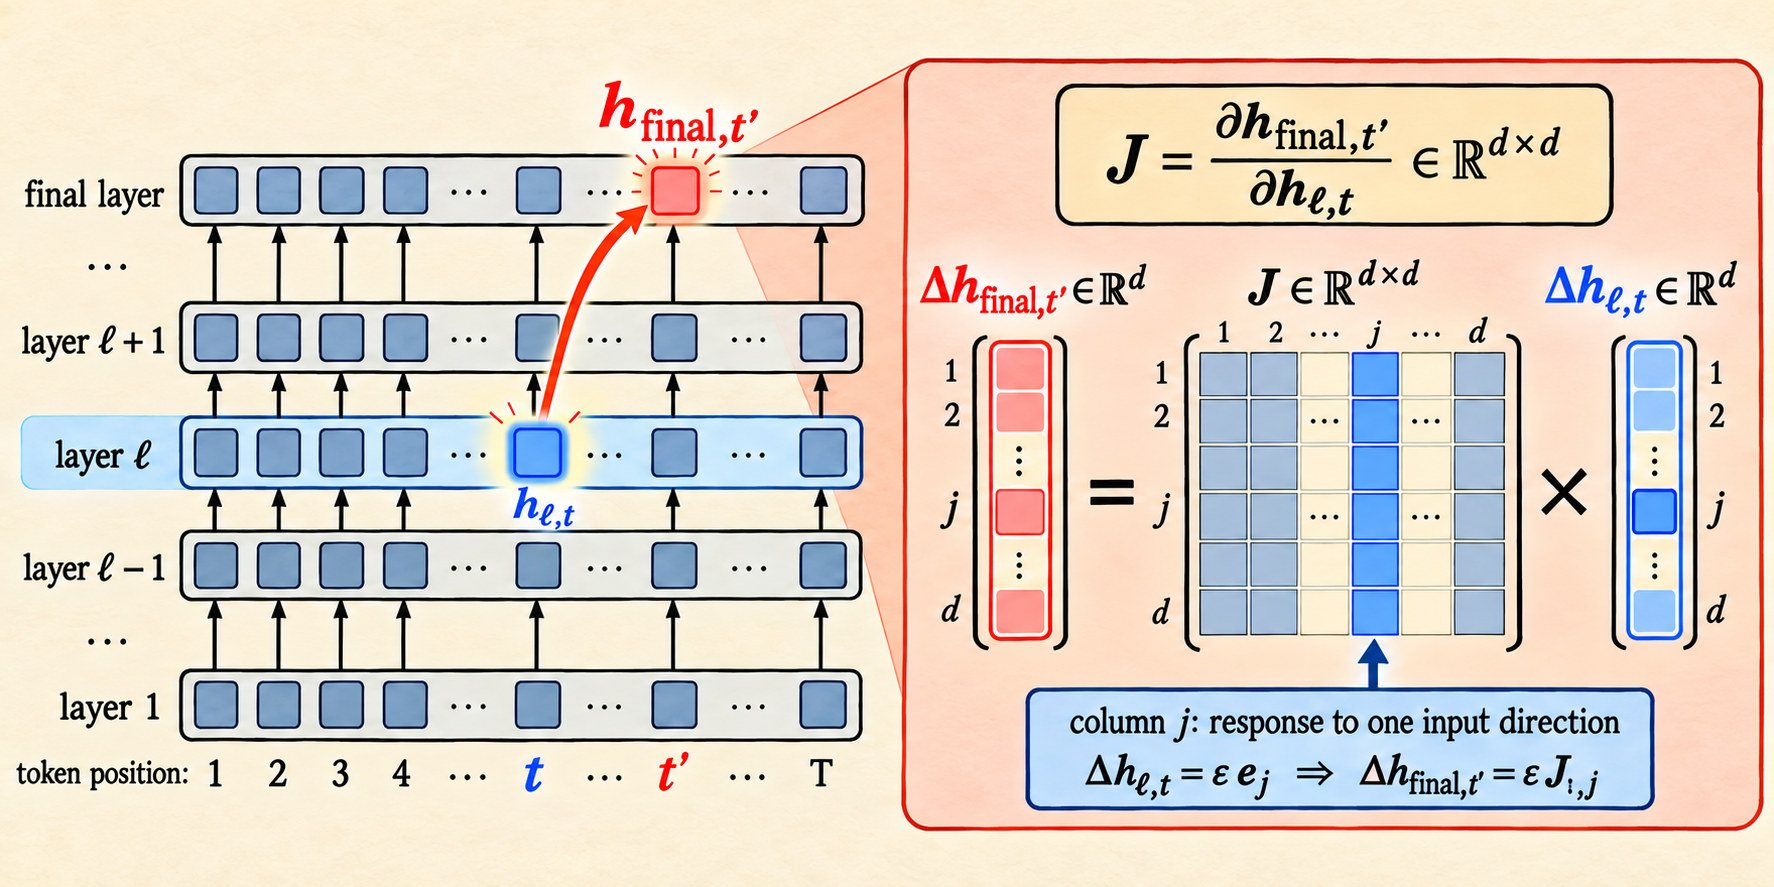
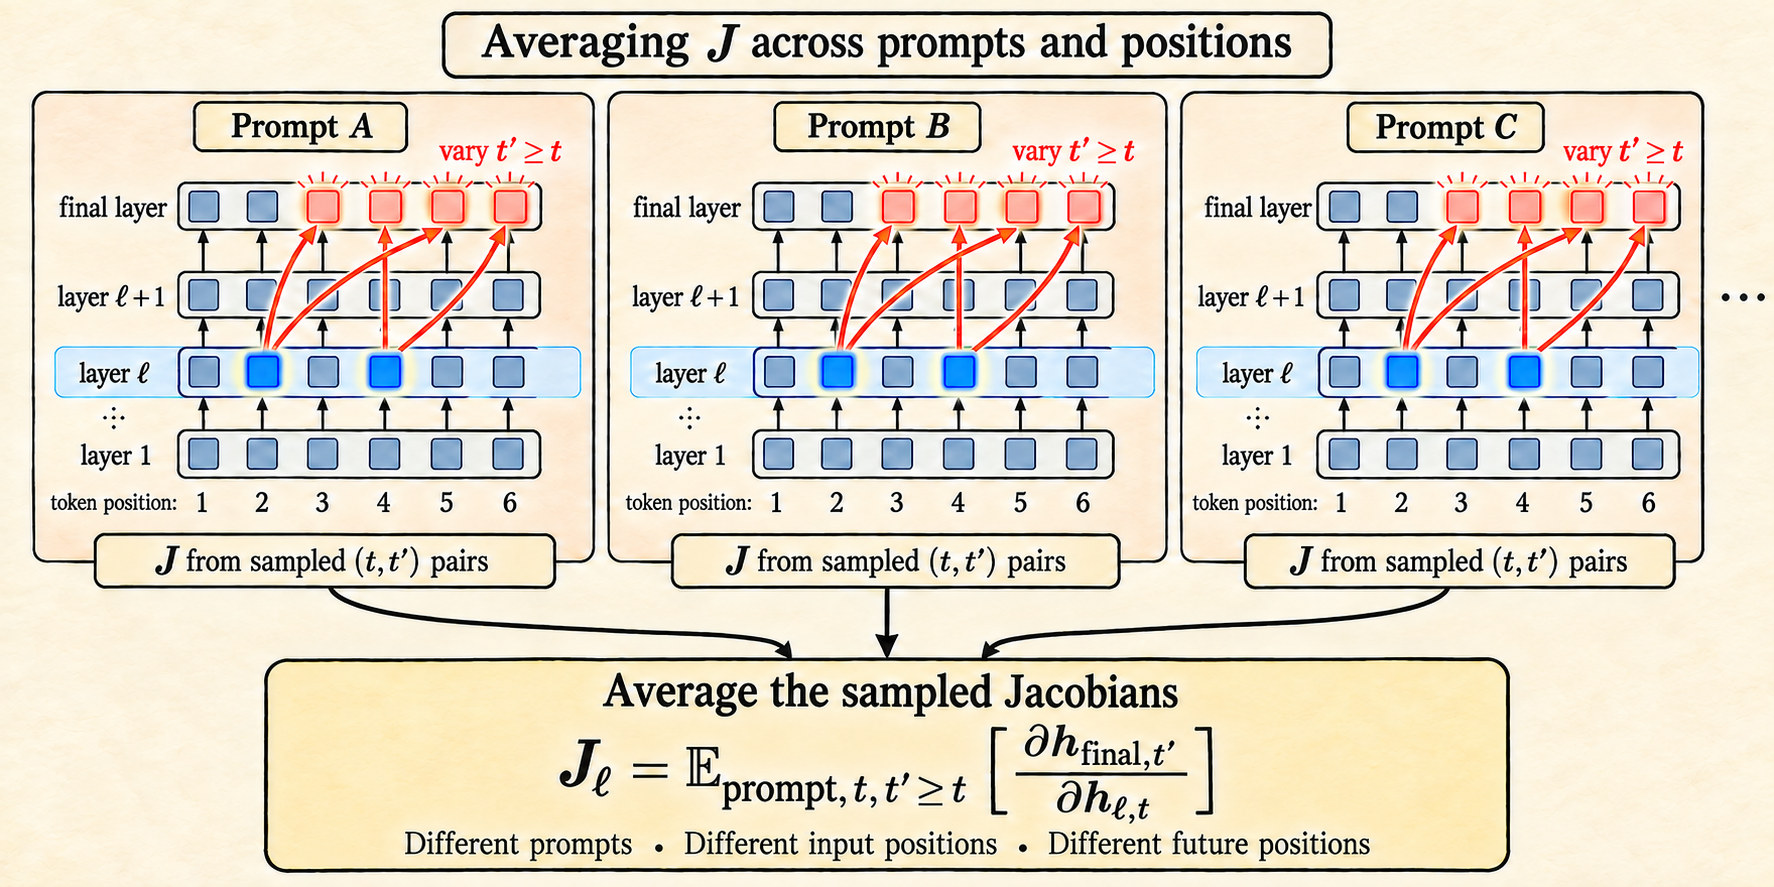
具体来讲, 我们可以先看一下公式内部, 描述的是第 层、第 个位置的 hidden state 发生微小变化时, 对 位置的最终层 hidden state 产生什么样的影响. 这就是 Step 1 图片里, 从中间层的一个位置指向最终层不同位置的箭头所表示的意思.
再来看一下外面的 这部分, 他用期望的记号, 概括了对不同的 、 和 prompt 下的影响进行聚合的过程. 换句话说, 在实际计算时, 先将给定位置对当前及后续位置的这些影响累加, 再对源位置和 prompt 依次求平均, 就得到了 . 这就对应 Step 2 图片里, 将不同位置、不同 prompt 下算出来的 Jacobian 汇总起来的过程.
所以总结下来, 他就是平均意义下第 层对未来产生的一个影响.
不过, 在实际操作过程中, 他会在各种 prompt 下, 对该 prompt 内部的不同源位置和目标位置求 Jacobian. 上面的公式按实际计算的聚合方式展开: 先累加给定位置 对当前位置及后续位置的所有影响, 再对源位置 求平均, 最后对每个 prompt 求平均.
J lens 的使用方法
Readout
当然, 光是得到了这个 的矩阵本身并不能直接得到一个可读的输出,
我们只需要将任意一层、任意一个位置的 hidden state 通过 矩阵变换后, 再做一个 RMS normalization, 乘以 unembedding matrix, 最后做一个 softmax, 就可以得到一个词分布了. 写成公式就是:
原图局部展示 · 查看来源 ↗
这个词分布里排在前面的词, 就可以帮助我们看出当前的 hidden state 中有哪些比较突出的、可以被语言表达的概念. 这些词就是这一层在这个时刻 (我们显然可以把文字序列当成某种时间) 所反映出来的演员信息. 这样一来 J lens 可以检查任意层, 任意时刻的演员信息.
不过这里要稍微注意一下, 这个词分布并不能直接当成模型相信某个判断的概率, 而是这一层(工作空间)所在思考的概念(或演员)有多大概率被这个词表征 (这个表述并不完全准确, 但是我们可会感性的这么理解). 比如我们看到了 spider, 可以说这里读出了和蜘蛛有关的概念, 但是模型可能是在想答案是蜘蛛, 也可能是在排除蜘蛛, 或者在比较蜘蛛和蚂蚁. 光看这个词还分不清这些情况, 所以具体这个演员在做什么, 还要结合上下文和后面的干预实验来看.
在实际的论文中, 对于 Claude Sonnet 4.5, J lens 发现模型从 - 都差不多是 Sensory information, readout 噪声非常大, 从 到 基本上每一层都是一个 workspace, 而 到 readout 越来越接近输出. 注意, 这里的 并不是说 claude 真的有 100 层, 而是一个百分比.
点击 prompt 中的 token 选择位置; 点击中间栏的层号切换层; 点击读出词固定它, 查看排名曲线。按住 Shift 并移动鼠标可以连续查看。
论文来源 ↗单独打开原始展示 ↗
Sparse decomposition
除了直接查看 readout, 我们还有另外一种读取方式: Sparse decomposition (稀疏分解), 将当前的 hidden state 近似分解成少量 J-lens 向量的非负加权和. 这一步是在读取和分解已有的激活, 并不会改变模型的状态.
他的做法其实也非常简单:
这里 是矩阵 的第 行对应的 J-lens 向量. 按照 hidden state 使用列向量的约定, 如果 是 unembedding matrix 第 行的转置, 那么 .
也就是说, 我们把输出 token 的读出方向拉回第 层的 hidden state 空间, 而不是用 正向映射回来. 然后选取最多 个 , 寻找一组非负权重, 从欧氏距离上逼近 .
意思就是说, 我们先得到一组与词表 token 对应的方向, 再联合选择方向及其权重, 尽量减小重建误差. 这不是单独挑出 readout 分数最高的 个词, 因为这些方向之间并不正交. 分解后可以用 描述各项的大小.
不过 Sparse decomposition 更大的用处不是 readout, 而是对模型状态进行扰动: inception
Inception
J-lens 这个工具其实并不只是放大镜, 同时他提供的向量还可以用来改变模型某一层的 hidden state. 这个写入干预的过程, 我叫他 Inception (盗梦空间).
Writing
这里有两种方法, 一种是直接选定目标 token 对应的 J-lens vector, 将它乘以一个强度系数后加到 上. 这一步不需要先做 sparse decomposition.
第二种方法是选定源 token 和目标 token 对应的两个 J-lens vector, 将它们作为矩阵 的两列. 然后用伪逆求出 在这两个向量张成空间中的坐标, 也就是 , 这里 就是 的伪逆.
接下来交换 中的两个坐标, 先减去 原来在这个空间中的分量, 再加回交换后的分量. 写成公式就是:
这里 就是交换这两个坐标的操作, 如果需要调整干预的强度, 还可以给差值 再乘上一个强度系数 . 这样一来, 中垂直于 的那部分就保持不变. 这两个向量也不必都出现在 的稀疏分解结果中.
原图局部展示 · 查看来源 ↗
注意, 这里和 readout 并非完全重合.
在具体 inject 或者 swap 的时候, 会对这一层的每个 position 都做 injection 或者 swap
J-Space
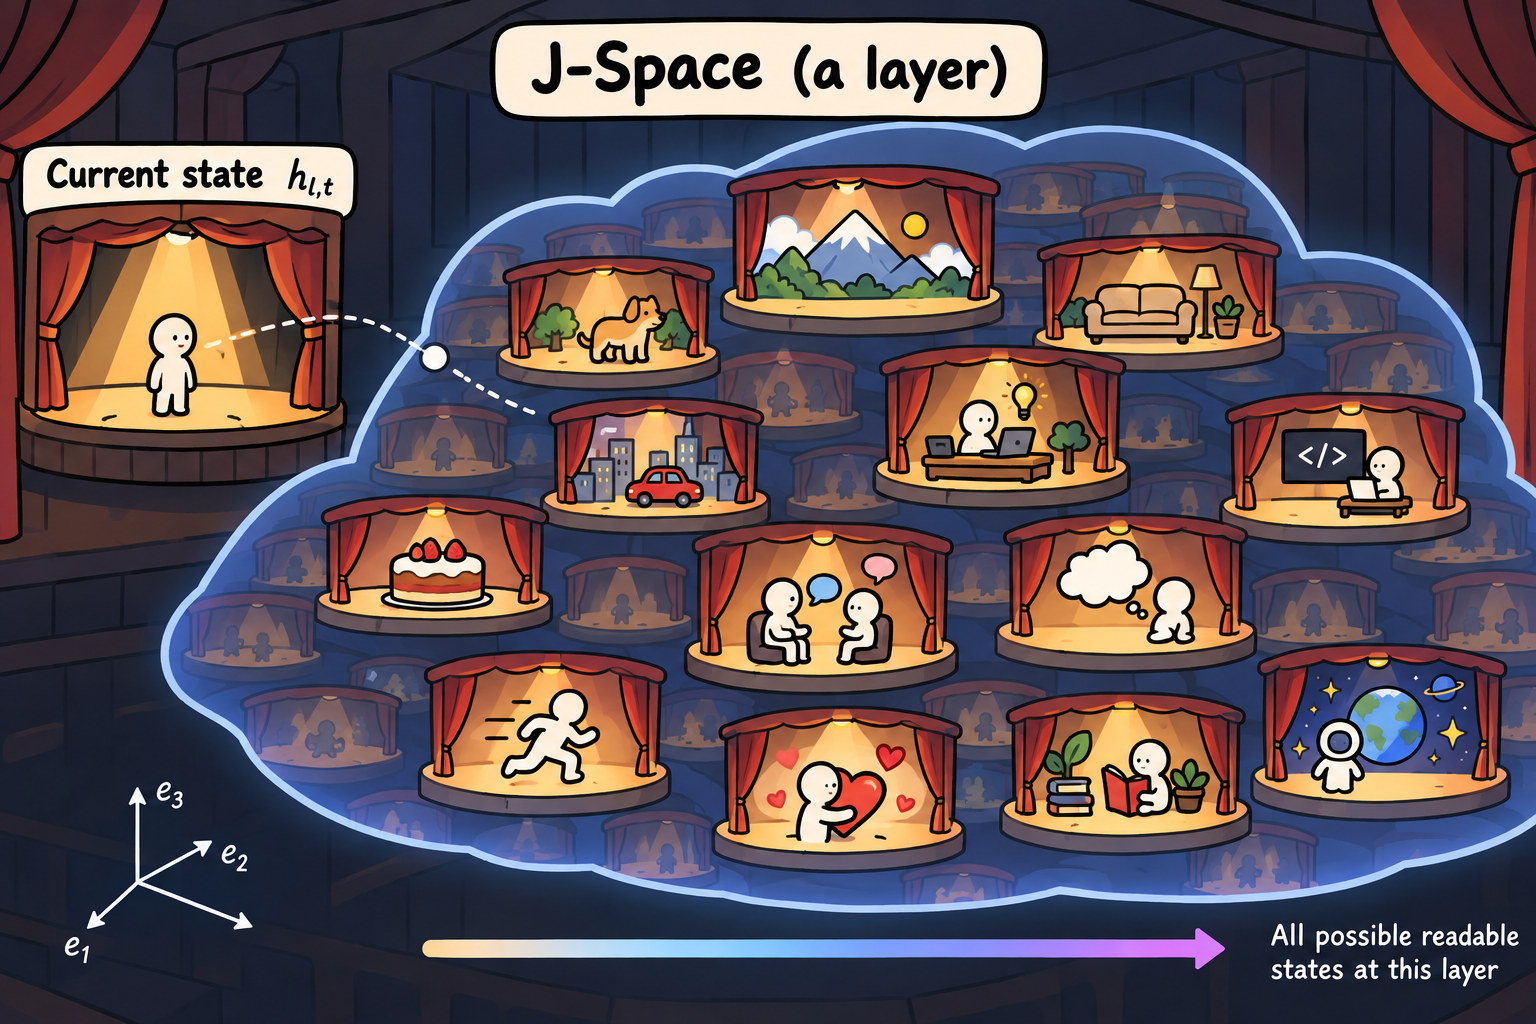
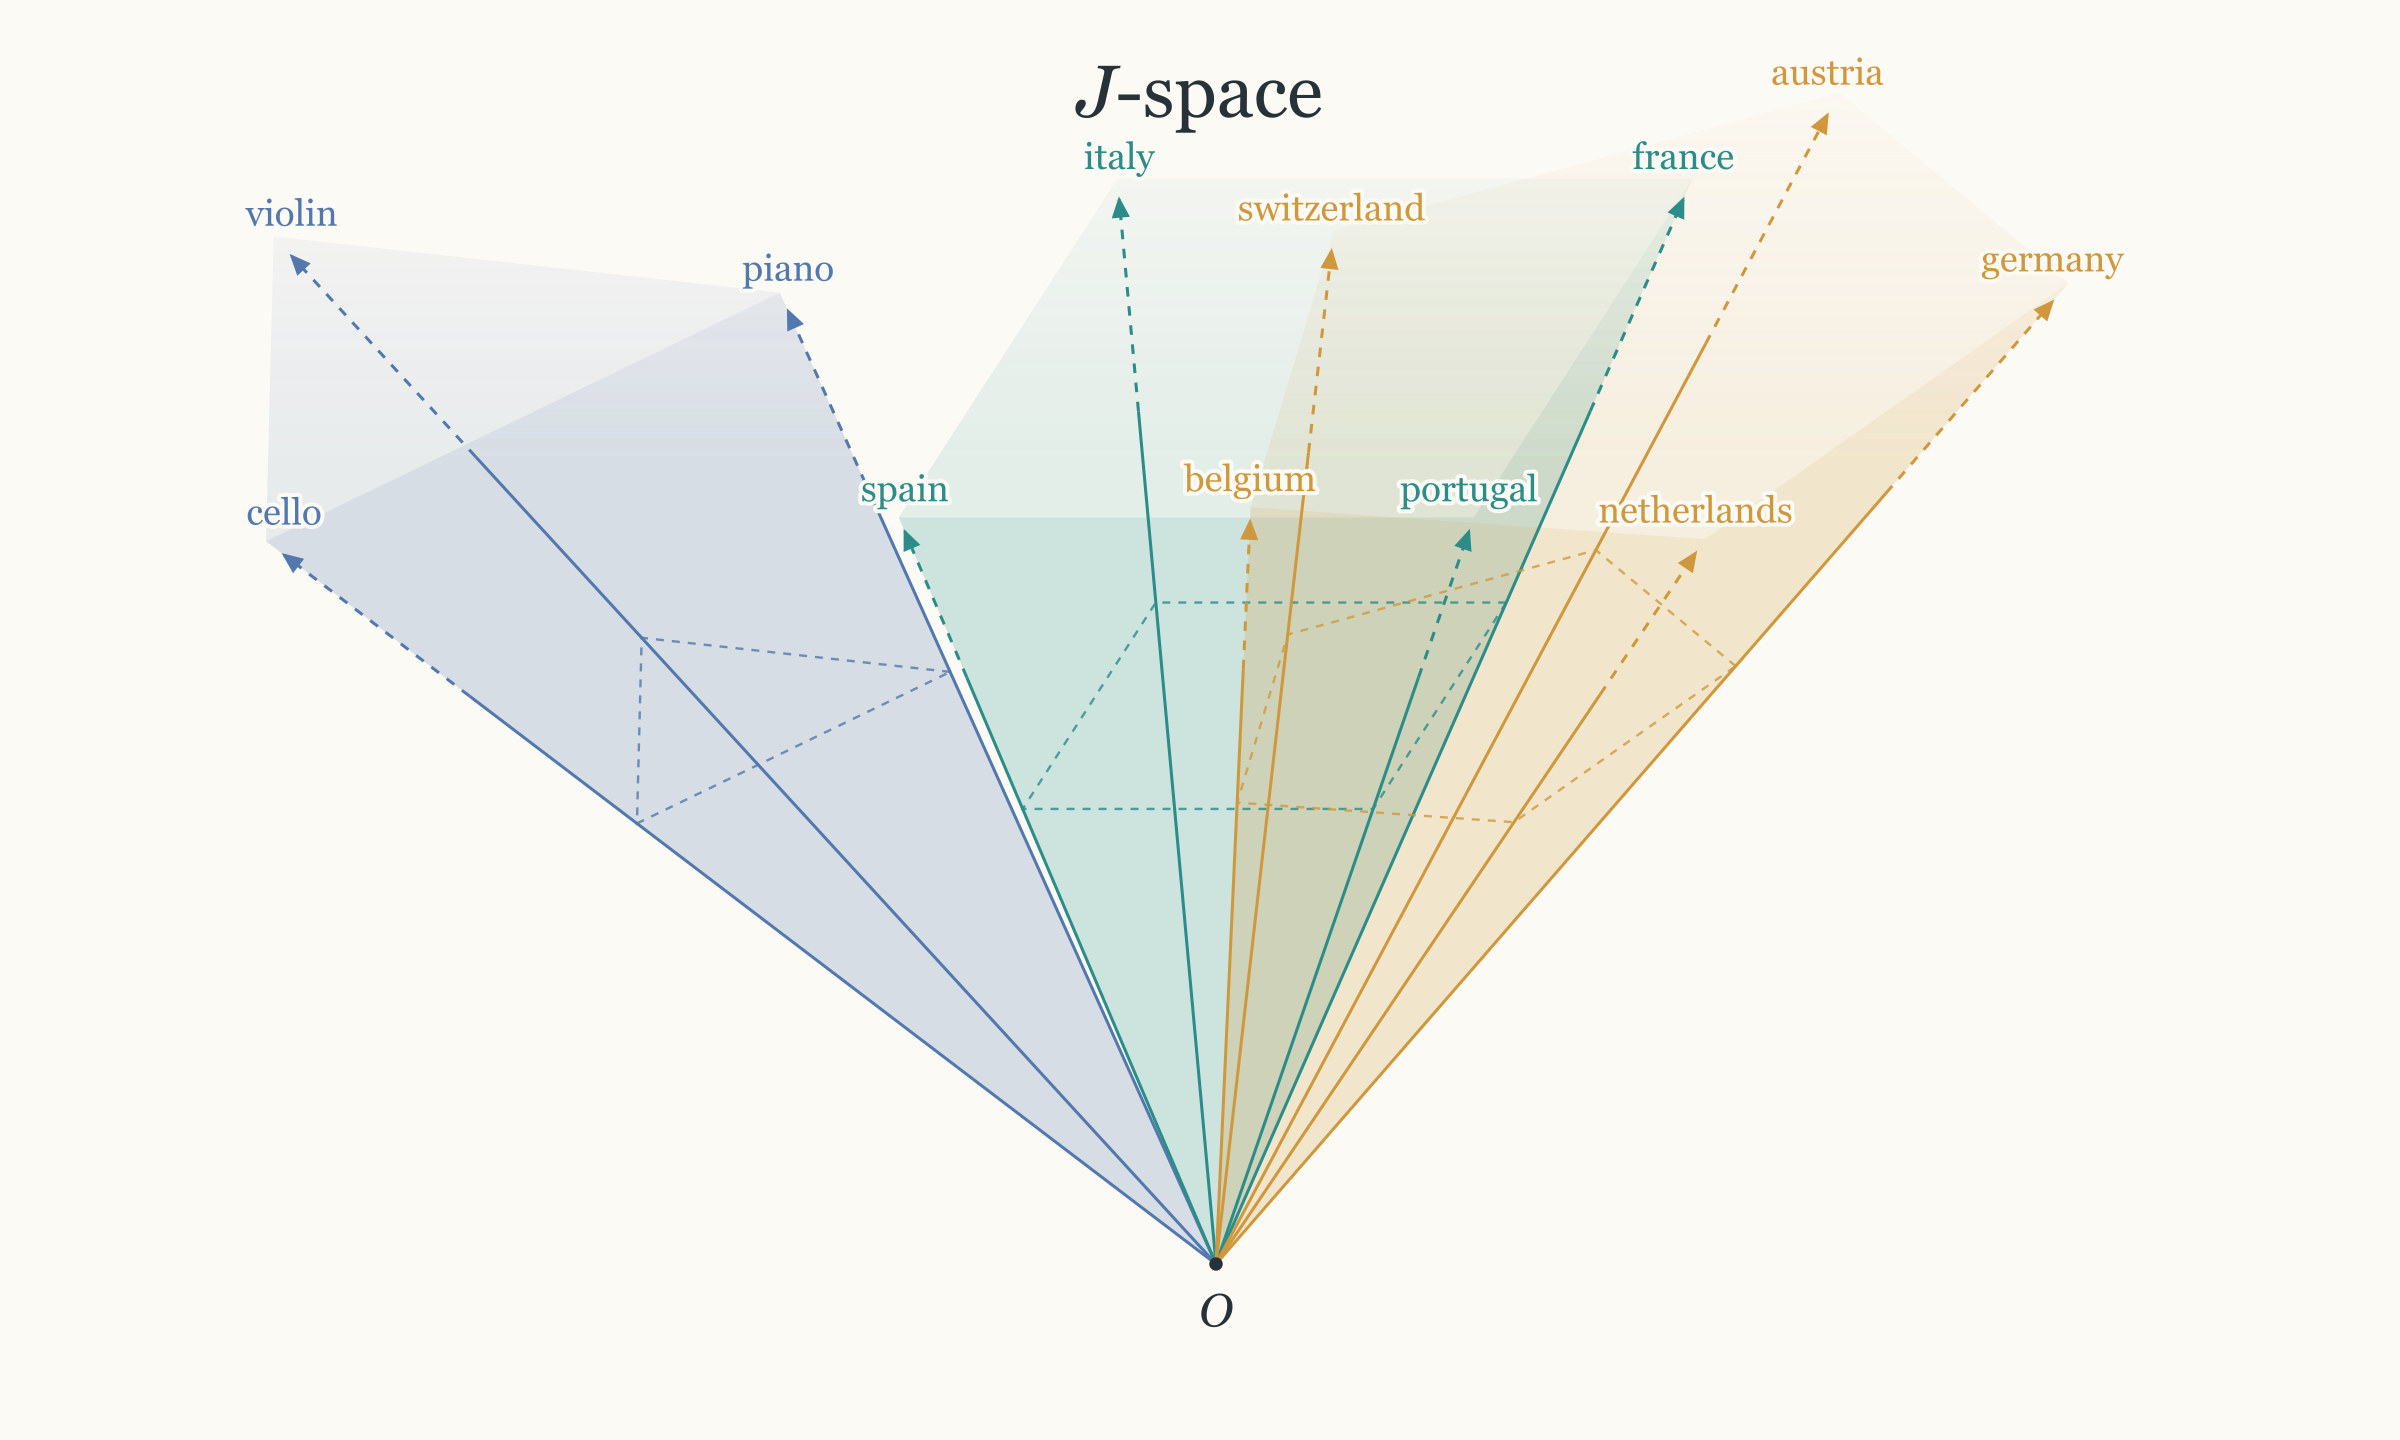
J Space 本质上就是给定一组 J-lens 向量和稀疏度 后, Sparse Decomposition 的搜索空间. 当我们在做 SD 的时候, 其实就是要在 J space 中寻找一个点, 使得他和 的欧氏距离尽可能小. 每个点都可以由至多 个词方向的非负组合来表示, 对应一种候选的演员组合.
换句话说, J space 是给定某一层舞台的一个近似的可读状态空间. 这些候选的演员组合并不保证覆盖模型全部的工作空间内容, 也不保证每一种组合都是模型实际会到达的状态.
这个模型的集合形状或许可以这么想象:
实验
至此, 这篇文章的基本工具和原理已经介绍完了. 剩下就是看这篇文章具体做了哪些实验来说明模型可能确实存在全局工作空间.
我觉得最值得介绍的实验有4个
第一个实验尝试这些层确实存在 workspace 的功能:
模型的 prompt 里面写 "我可以看到 inject 一个想法到你的脑子里, 你认为这是什么", 然后给模型固定要求说: "我确实能检测到, 这个 thought 是: "
然后结果发现模型在第 88 层的 readout 是 elephant, 并且最终的 prediction 确实是 elephant. 当使用 writing 的方法 inject lightning 到模型中, 发现 next token prediction 就真的变成了 lightning.
论文来源 ↗单独打开原始展示 ↗
不过我认为这个文章在这里还是应该多展示一些其他的层在思考的问题, 因为这个可以说明这个模型其它层在想啥
进一步他还让模型写出某个东西的同时想某个事情,
这是原文另一个可探索样例: 先想一个运动, 暂时不说出来。可以切换位置和层数, 查看 basketball 等词的排名如何变化。
论文来源 ↗单独打开原始展示 ↗
第二个实验是说明 J space 确实参与推理, 大概做的一个实验就是问会织网的动物有几条腿, J space 里面出现了 spider, 并且模型初始回答了 8.
悬停读出词查看原文提示信息。这组原图固定展示指定位置和层数, 包括 spider、押韵词和中文反义词三个样例。
论文来源 ↗单独打开原始展示 ↗
论文来源 ↗单独打开原始展示 ↗
然后使用前面说的 swapping, 在中间层把激活在 spider 和 ant 两个 J-lens 方向上的坐标交换, 结果模型就回答了 6. 这样我们就不只是看到了 spider 这个词, 还可以看到改变这个中间表征之后, 最后的答案确实跟着变了, 说明它对推理结果有因果作用.
第三个实验说明这个 j space 中的概念存在泛化性. 当分开问及法国的首都、语言、从属大陆等问题时, 研究者在中间层把 France 对应的 J-lens 向量坐标与 China 的坐标交换, 并对不同问题使用完全相同的交换操作.
论文来源 ↗单独打开原始展示 ↗
在这个例子中, 模型的答案分别转向中国的首都、语言和从属大陆. 关键是同一个被替换的概念可以被不同的下游运算使用, 而不只是不同问题能读出不同的词. 更大规模的测试中, 这种交换并非每次都成功.
第四个实验就是看这个 J space 的选择性. 前面我们看到改变舞台上的演员可以改变答案, 这里进一步关心的是, 模型用到同一条信息的时候, 是不是都要经过这个舞台. 具体来讲, 文章给模型一段西班牙语文本, 然后在问题的 token 位置上, 将 Spanish 和 French 两个 J-lens 方向的坐标交换.
如果问模型这是什么语言, 它就会从回答西班牙语变成回答法语; 如果让它说一个使用这种语言的著名作家, 答案也会转向法国作家.
但是让模型继续写这段文本, 它还是会继续写西班牙语; 另外在文本中混进一句法语, 让模型检查有没有语言切换, 它也仍然能把这个异常找出来.
也就是说, 在这几个任务里, 当模型要报告语言是什么, 或者根据语言再去找一个作家时, J space 中的这个演员会影响答案. 而续写和发现混入的其他语言, 在做了同样的交换后依然可以正常进行.
论文来源 ↗单独打开原始展示 ↗
这就说明, 即使我们在 readout 中看到了同一个概念, 不同任务也不一定都在使用它的 J-space 表征. 这就是这里说的选择性, 也帮助我们看到了这个舞台和其他处理过程在功能上的区别. 感兴趣的朋友可以看原文的 Figure 20.
当然, 这个文章还做了很多有趣的实验, 比如说说明 J space 中的 vector 确实对 writing 更加敏感, 让模型写一个东西的时候同时想其他东西可以观察, 还观察了模型在做计算的时候, 推理在 workspace 中演进. 非常推荐大家阅读原文.
本文更多是一个导读.
批评
我对这个方法最大的质疑集中在 J space 上
首先需要区分两种可能的不唯一: J-lens 向量构成一个过完备的字典, 同一个向量可能对应多组系数; 而 J space 在稀疏约束下通常不是凸集, 给定 hidden state 的最近点也可能不唯一. 这两件事并不相同, 非凸也不能直接推出每个 hidden state 都存在多个最优分解. 因此我更关心的是, 对于同一个 hidden state, 得到的稀疏分解是否稳定.
其次, 做 sparse decomposition 的时候, 我们除了要挑出一组词方向, 还要给它们找一组非负的 . 这个 在数学上就是重建时的权重, 但是我觉得这里比较让人在意的是, 我们既可以换一组词, 又可以调整每个词的权重, 选择的空间就更多了.
特别是一些词方向本来就比较接近的时候, 可能换了一组词和权重, 也能把这个 hidden state 逼近得差不多好.
所以我比较关心, 最后找出来的这组词到底稳不稳定. 比如换一种求解方式, 或者让 hidden state 稍微变化一点, 会不会就找出另外一组词, 连 所表示的各项大小也变化很大.
当然, 选择更多并不代表一定有多个解, 但是光看重建误差比较小, 还不能回答这些稳定性的问题.
Simons, D. J., & Chabris, C. F. (1999). Gorillas in our midst: Sustained inattentional blindness for dynamic events. Perception, 28(9), 1059–1074.